Universo-Arena · Benchmark abierto de LLM + agente de código
Un prompt, muchos universos, juzgados por lo que hacen
Siete capítulos para entender cómo se mide cada entrega: el reto común, la rúbrica, la ejecución en un navegador real, las dos trampas que separan a las mejores, la calibración, la galería con su ficha y por qué todo es abierto y reproducible.
Desplázate, o usa ← → · I abre el índice · D cambia a diapositivas · M abre el mapa · F pantalla completa
Capítulo 1 · Quien compara modelos
El mismo reto para todos
Comparar modelos de IA de programación por opiniones o por benchmarks de texto no dice qué pasa cuando abres lo que entregan.
Cómo se resuelve
Cada combinación de modelo y agente de código recibe el mismo prompt y lo resuelve en una sola pasada: una simulación 3D del Sistema Solar con BabylonJS, en un único index.html que se abre con doble clic, sin servidor ni recursos locales.
Lo que se gana
Todas las entregas se comparan sobre la misma tarea.
Sol con corona, ocho planetas y Plutón, el cometa Halley, el cinturón de asteroides, las estrellas y un panel de control: lo que pide el reto.
Capítulo 2 · Quien compara modelos
Una rúbrica de 100 puntos
Una impresión general («se ve bien») no distingue una simulación correcta de una que solo lo parece.
Cómo se resuelve
Un jurado por entrega lee el archivo completo y el reto, y puntúa por categorías verificando el código, no los comentarios: la escena, las órbitas, el cometa, la estética, el panel, la cámara, el posprocesado, el rendimiento, la robustez y la calidad del código.
Lo que se gana
Sabes en qué acierta y en qué falla cada entrega, no solo su nota.
La rúbrica completa y la metodología están en el repositorio.
Capítulo 3 · Quien compara modelos
Juzgado por lo que hace al abrirse
Leer el código no basta: un programa puede parecer correcto y fallar al ejecutarse, o parecer roto y funcionar.
Cómo se resuelve
Cada entrega se abre en Chrome sin pantalla, con WebGL por SwiftShader. Se captura lo que se ve y se cuentan los objetos en escena, los fotogramas por segundo y los errores de consola.
Lo que se gana
La nota refleja lo que ve quien abre la simulación, no lo que promete el código.
Los datos de cada ejecución están en assets/runtime.json.
Capítulo 4 · Quien busca los detalles difíciles
Las dos trampas
Casi todas las simulaciones se ven bien a primera vista. Lo que separa a las mejores son dos detalles de física que es fácil equivocar.
Cómo se resuelve
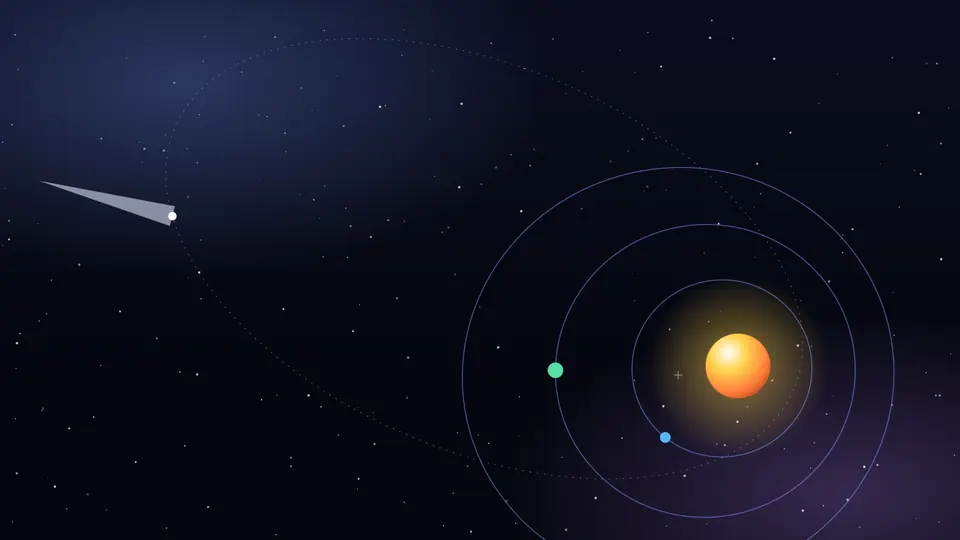
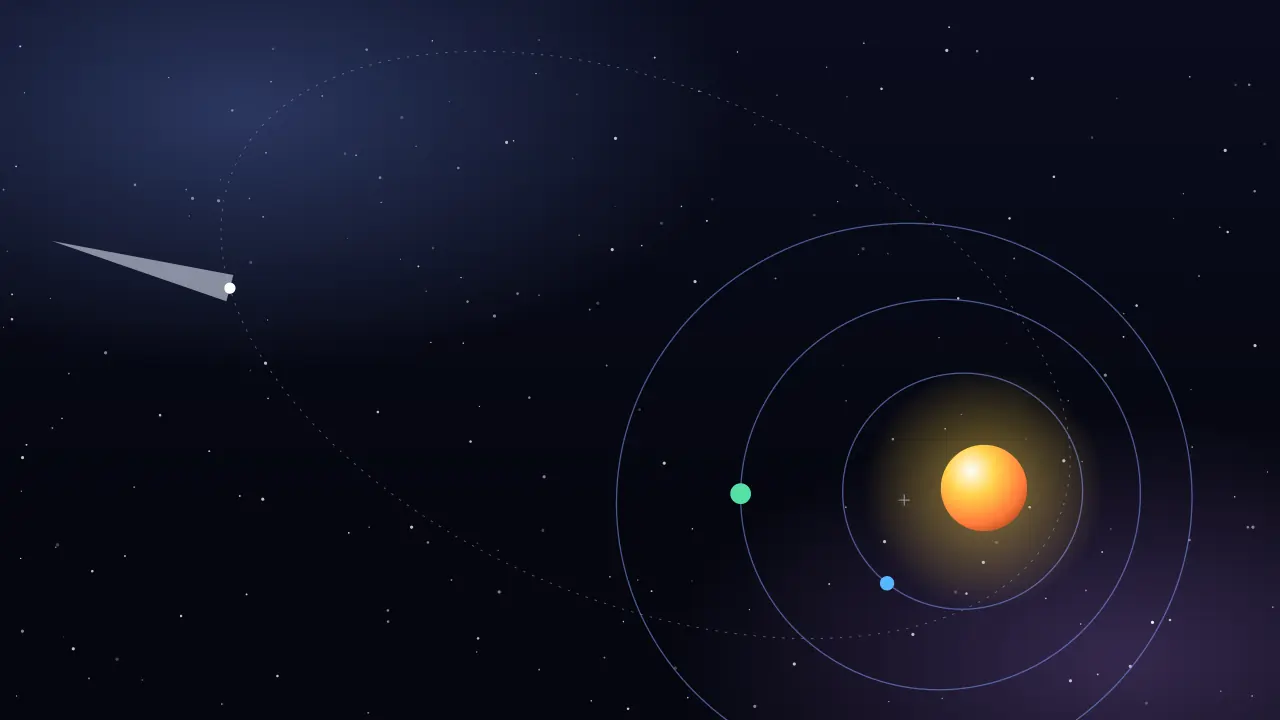
El Sol va en el foco de la elipse, no en el centro (x = a·cosθ − a·e, z = b·sinθ), y la cola del cometa apunta en el sentido cometa − Sol, recalculada en cada fotograma. La figura es la órbita del manual de marca, dibujada por código para que la física sea la correcta.
Lo que se gana
Ves qué entregas aciertan los detalles difíciles, no solo cuáles se ven bonitas.
En cada ficha, los requisitos cumplidos: órbitas elípticas, cola lejos del Sol, instancing y más.
Capítulo 5 · Quien desconfía de los jueces
La calibración
Distintos jurados puntúan con distinta generosidad, y un juez que solo lee el código se puede equivocar.
Cómo se resuelve
Un juez normaliza las notas entre jurados. Cuando la lectura del código y la ejecución discrepan, manda la ejecución: una revisión estática declaró «pantalla negra» a una entrega que, al abrirla, funcionaba sin errores. En los empates de cabeza, las entradas del mismo sistema que ejecuta el benchmark van por debajo.
Lo que se gana
Un ranking que no depende de la generosidad de un jurado ni de quién organiza la prueba.
Cada tanda de entregas tiene su registro en el repositorio.
Capítulo 6 · Quien explora las entregas
La galería y la ficha
Una tabla de notas no deja ver qué entregó cada combinación ni por qué sacó esa nota.
Cómo se resuelve
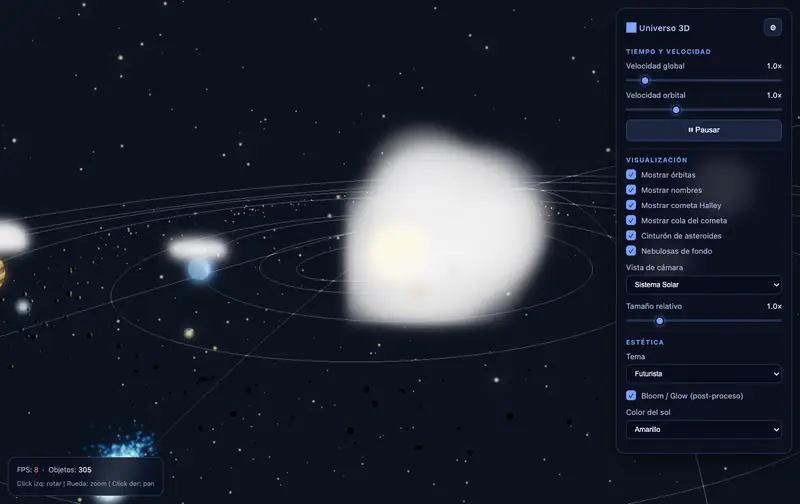
Cada tarjeta es una combinación de modelo y agente, con la captura real de lo que se ve al abrirla. Puedes ordenar por categoría, filtrar por tier, abrir la demo en vivo y abrir la ficha: el desglose por categoría, los requisitos, lo que hizo bien y lo que falló.
Lo que se gana
Compruebas tú mismo cada nota abriendo la entrega.
El podio, la galería completa y los hallazgos, en la portada.
Capítulo 7 · Quien quiere verificarlo
Abierto y reproducible
Un ranking que no publica sus datos ni su método obliga a creerle.
Cómo se resuelve
Todo está en GitHub con licencia MIT: el código de cada entrega, los datos crudos (benchmark.json y runtime.json), la rúbrica, la metodología, las conclusiones y cómo añadir una entrega. El arnés de captura está documentado en docs/harness.md; su script no vive en el repositorio.
Lo que se gana
Puedes revisar cada nota y repetir la medición.
Datos crudos en assets/benchmark.json y assets/runtime.json.
Seguridad comprobada
No te pedimos que nos creas: compruébalo
Herramientas públicas e independientes revisan este sitio: el cifrado de la conexión, las protecciones del navegador, la reputación ante los motores antimalware, el código y la accesibilidad. Aquí está lo que dicen, con la fecha de la medición, una captura real del informe y el enlace para que lo verifiques en la fuente.
Publicamos aquí las verificaciones en las que hoy tenemos la calificación más alta. Cada semana se vuelven a medir de forma automática; si un resultado deja de cumplir, sale de esta página hasta que lo corregimos. En las capturas se omite la dirección del servidor. Para reportar una vulnerabilidad: security.txt.
Eso es Universo-Arena
Un reto común, una rúbrica, la ejecución como árbitro y todos los datos a la vista. Abre las entregas y compruébalo.